
第4回:World Modelとは?AIが「現実世界」を理解する仕組み

目次
World Modelとは?AIが「現実世界」を理解する仕組み
前回は、ロボットが周囲を見て、人間の言葉を理解し、実際の行動につなげる「VLA(Vision-Language-Action)」について紹介しました。
しかし、ロボットが現実世界で安全に行動するためには、「何をすればいいのか」を判断するだけでは十分ではありません。
自分が行動すると、そのあと何が起こるのかを予測する能力も必要です。
例えば、テーブルの端に置かれたコップを強く押せば、コップが落ちて割れてしまうかもしれません。
人間であれば、実際にコップを押さなくても、ある程度その結果を想像できます。
こうした「世界がどのように動くのか」をAIに理解させるための技術として注目されているのが「World Model(世界モデル)」です。
今回は、フィジカルAIを理解するうえで重要なWorld Modelについて、初心者向けに分かりやすく紹介します。
World Modelとは?
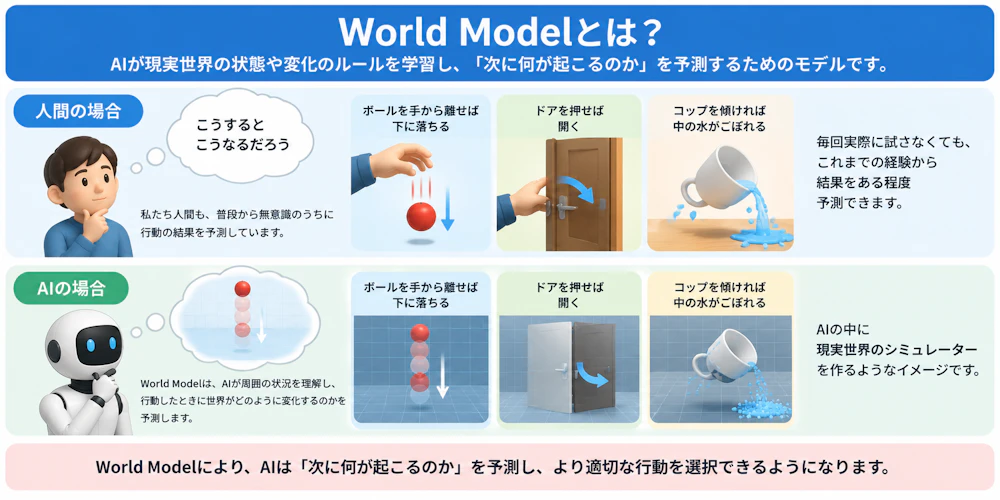
World Modelとは、AIが現実世界の状態や変化のルールを学習し、「次に何が起こるのか」を予測するためのモデルです。
私たち人間も、普段から無意識のうちに似たような予測をしています。
例えば、ボールを手から離せば下に落ちる、ドアを押せば開く、コップを傾ければ中の水がこぼれる、といったことです。
毎回実際に試さなくても、これまでの経験から結果をある程度予測できます。
World Modelも同じように、AIが周囲の状況を理解し、ある行動をしたときに世界がどのように変化するのかを予測することを目指します。
簡単にいえば、AIの中に「現実世界のシミュレーター」を作るようなイメージです。
なぜロボットにはWorld Modelが必要?
ロボットが工場や家庭などで活動する場合、現実世界ではさまざまな状況が発生します。
例えば、テーブルの上に水の入ったコップが置かれているとします。
ロボットがコップを移動させたい場合、単純に「コップをつかんで移動する」という行動だけを考えればよいわけではありません。
強く握ればコップが壊れるかもしれません。横から押せば倒れるかもしれません。傾けながら運べば、中の水がこぼれる可能性もあります。
つまり、ロボットには「この行動をすると、そのあと何が起こるのか」を考える能力が必要です。
そこでWorld Modelを使って行動の結果を予測し、より安全で適切な行動を選択できるようにします。
これは、自動運転でも同じです。
前を走っている車が減速した場合、そのまま進めば衝突する可能性があります。歩行者が道路に近づいている場合には、「このあと道路を渡るかもしれない」と予測する必要があります。
現実世界で活動するAIにとって、現在の状況を認識するだけではなく、少し先の未来を予測することが重要なのです。
LLMとWorld Modelの違い
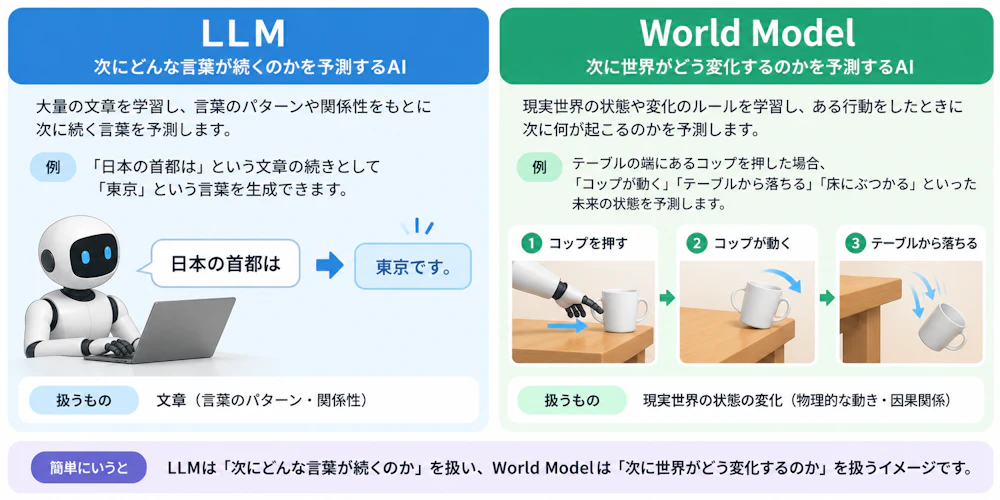
ChatGPTなどで使われているLLMとWorld Modelでは、主に扱う対象が異なります。
LLMは、大量の文章を学習し、言葉のパターンや関係性をもとに次に続く言葉を予測します。
例えば、「日本の首都は」という文章があれば、その続きとして「東京」という言葉を生成できます。
一方、World Modelが予測しようとするのは、世界の状態の変化です。
例えば、テーブルの端にあるコップを押した場合、「コップが動く」「テーブルから落ちる」「床にぶつかる」といった未来の状態を予測します。
非常に簡単に整理すると、LLMは「次にどんな言葉が続くのか」を扱い、World Modelは「次に世界がどう変化するのか」を扱うイメージです。
ただし、実際のAIシステムでは両者が完全に分離しているわけではなく、言語、画像、動画、行動など複数の情報を組み合わせる研究も進んでいます。
AIはどうやって未来を予測する?
では、World Modelはどのように未来を予測するのでしょうか。
基本的な考え方は、大量のデータから「世界がどのように変化するのか」を学習することです。
例えば、AIに大量の動画を学習させるとします。
動画には、人が歩く、ボールが転がる、物が落ちる、車が曲がるなど、時間とともに世界が変化する様子が含まれています。
AIはこうしたデータから、現在の状態と次の状態の関係を学習します。
例えば、ボールが右方向へ転がっている映像を見れば、「次の瞬間には、さらに右へ移動している可能性が高い」と予測できます。
さらにロボットの場合は、「現在の状態」だけではなく、「自分がどのような行動をするのか」も重要になります。
コップを右に押した場合と左に押した場合では、その後の状態は変わります。
そのため、現在の状態とロボットの行動から、次にどのような状態になるのかを予測することがWorld Modelの重要な役割になります。
シミュレーションが重要になる理由
フィジカルAIの開発では、シミュレーションも重要な役割を持っています。
ロボットを賢くするためには、さまざまな状況を経験させる必要があります。
しかし、すべての学習を現実世界で行うのは簡単ではありません。
例えば、ロボットに何百万回も物を持たせたり、転倒させたり、さまざまな部屋を歩かせたりすると、膨大な時間とコストがかかります。
ロボット本体が壊れる可能性もあります。
そこで、コンピューター上に仮想的な環境を作り、その中でロボットを学習させます。
仮想空間であれば、ロボットが失敗しても実際の機械が壊れることはありません。また、環境や物の配置を変えながら、大量のパターンを効率的に経験させることもできます。
こうしたシミュレーション技術は、フィジカルAIを学習させるうえで重要になっています。
デジタルツインとは?
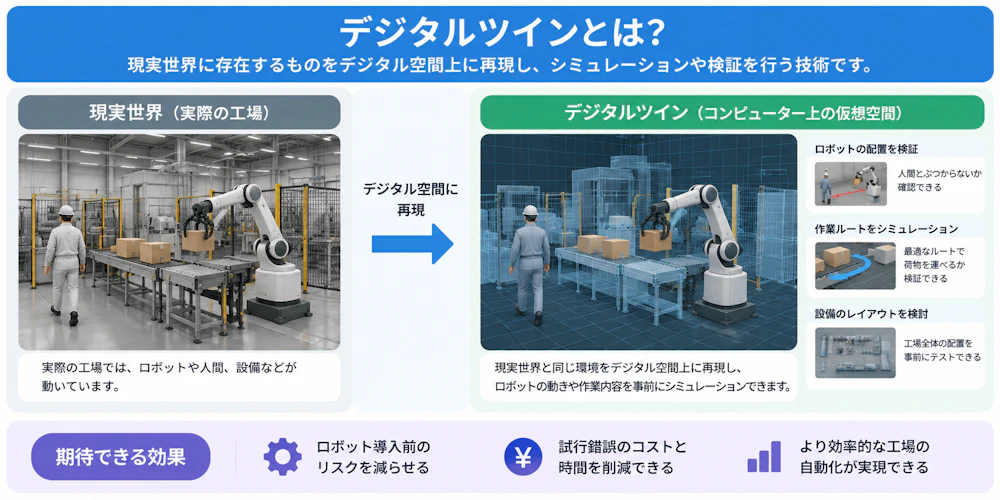
シミュレーションと関連してよく登場する言葉が「デジタルツイン」です。
デジタルツインとは、工場、建物、機械、都市など、現実世界に存在するものをデジタル空間上に再現する技術です。
例えば、実際の工場と似た環境をコンピューター上に作り、そこでロボットの動きを事前に確認します。
「この場所にロボットを配置すると、人間とぶつからないか」「このルートで荷物を運べるか」といったことを、実際の工場にロボットを導入する前に検証できます。
現実世界とデジタル世界を組み合わせることで、ロボット開発や工場の自動化をより効率的に進められる可能性があります。
Sim-to-Realとは?
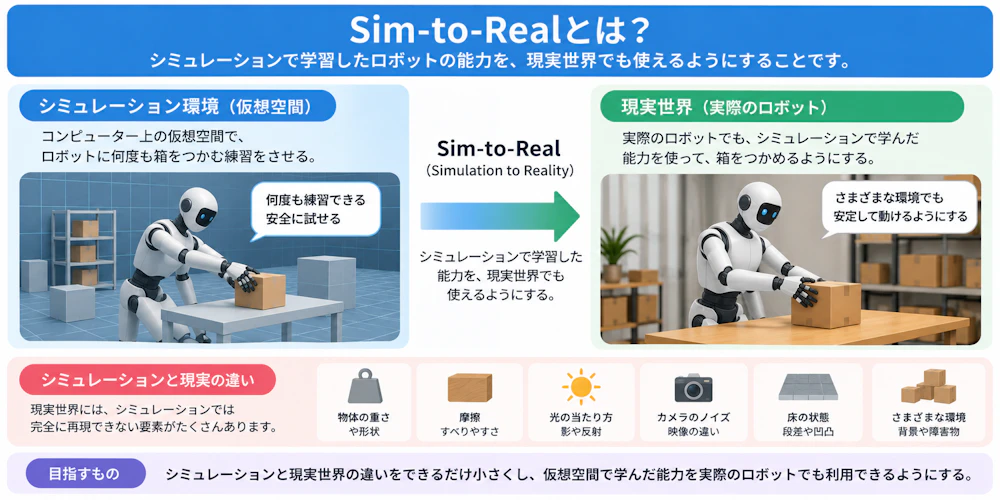
シミュレーションでロボットを学習させる場合、重要になるのが「Sim-to-Real」という考え方です。
Sim-to-Realとは、Simulation to Realityの略で、シミュレーション環境で学習した能力を現実世界でも使えるようにすることです。
例えば、仮想空間の中でロボットに何度も箱をつかむ練習をさせたとします。
シミュレーションでは上手に箱をつかめても、現実世界では同じように成功するとは限りません。
現実には、物体の重さや摩擦、光の当たり方、カメラのノイズ、床の状態など、シミュレーションでは完全に再現できない要素が存在するからです。
このシミュレーションと現実世界の違いをできるだけ小さくし、仮想空間で学んだ能力を実際のロボットでも利用できるようにすることがSim-to-Realの重要なテーマです。
World ModelとVLAはどうつながる?
前回紹介したVLAとWorld Modelは、フィジカルAIを理解するうえで深く関係しています。
VLAは、ロボットが「見る」「言葉を理解する」「行動する」をつなげる技術です。
例えば、「テーブルの上にあるコップを取って」と指示された場合、ロボットはコップを認識し、その場所まで腕を動かしてコップをつかみます。
ここにWorld Modelの考え方が加わると、単に行動するだけではなく、その行動によって何が起こるのかを予測できるようになります。
例えば、
コップを横から押す → 倒れるかもしれない
強く握る → 壊れるかもしれない
ゆっくり上からつかむ → 安全に持ち上げられそう
といった複数の可能性を考え、その中からより適切な行動を選択するイメージです。
VLAが「何をするのか」を現実の動作につなげる技術だとすれば、World Modelは「その行動をすると何が起こるのか」を予測するための技術と考えると分かりやすいでしょう。
World ModelがフィジカルAIを変える
World Modelが進化すると、ロボットは実際に行動する前に、その結果をある程度予測できるようになる可能性があります。
これは、フィジカルAIにとって非常に重要です。
生成AIの場合、間違った文章を生成しても、多くの場合は画面の中で問題が完結します。
しかし、ロボットや自動運転車は現実世界で動きます。
判断を間違えれば、物を壊したり、人にぶつかったりする可能性があります。
そのため、フィジカルAIには「とりあえず動いて試す」だけではなく、「この行動をしたら何が起こるのか」を事前に予測する能力が求められます。
将来的には、ロボットが頭の中で複数の行動をシミュレーションし、その中から安全で効率的な行動を選ぶようになるかもしれません。
人間が行動する前に「こうしたら、こうなるだろう」と考えるのと似た仕組みです。
World Modelの現在の課題
World Modelにも、まだ多くの課題があります。
最大の問題のひとつが、現実世界が非常に複雑であることです。
現実には、人、物、天候、光、音、摩擦、重力など、さまざまな要素が存在します。
さらに、人間が突然予想外の行動をしたり、物が壊れたり、環境そのものが変化したりすることもあります。
こうした現実世界のすべてを完全にモデル化することは簡単ではありません。
また、AIが予測した未来が必ず正しいとは限りません。
そのため、World Modelだけに判断を任せるのではなく、実際のセンサー情報を継続的に確認しながら行動を修正していく仕組みも必要になります。
World Modelは「未来を完璧に当てる技術」というより、「これから起こりそうなことを予測し、より良い行動を選ぶための技術」と考えると分かりやすいでしょう。
まとめ
World Modelとは、AIが世界の状態や変化のルールを学習し、「この行動をすると次に何が起こるのか」を予測するためのモデルです。
フィジカルAIが現実世界で安全に活動するためには、周囲を認識して行動するだけではなく、その行動の結果まで考える必要があります。
そこで、VLAによる「見る・理解する・動く」という能力と、World Modelによる「その先を予測する」という能力を組み合わせることが重要になります。
さらに、ロボットを効率的に学習させるためには、シミュレーション、デジタルツイン、Sim-to-Realといった技術も重要です。
AIは「文章を生成する存在」から「画像や動画を理解する存在」へ進化し、さらに現実世界を理解して行動する存在へと広がりつつあります。
そして、そのAIが実際に工場、物流、自動車、家庭などへ入っていくと、私たちの社会や仕事はどのように変わるのでしょうか。
次回はシリーズ最終回として、「フィジカルAIで社会はどう変わる?2030年代のロボット社会」について紹介します。
※ 本記事の内容は、執筆時点での情報に基づいています。最新の情報と異なる場合がございますので、あらかじめご了承ください。 また、記載されている内容は一般的な情報提供を目的としており、特定の状況に対する専門的なアドバイスではありません。 ご利用にあたっては、必要に応じて専門家にご相談ください。