
第3回:ロボットの頭脳「VLA」とは?言葉を理解して動くAI

目次
ロボットの頭脳「VLA」とは?言葉を理解して動くAI
近年、AIの進化によって、ロボットは単に決められた動きを繰り返すだけではなく、周囲の状況や人間の指示を理解して行動できるようになってきています。
その中で重要な技術として注目されているのが「VLA」です。
VLAとは「Vision-Language-Action」の略で、カメラなどから得た視覚情報、人間から与えられた言葉、ロボットが実行する行動を結びつけるAIの仕組みです。
例えば、人間がロボットに「テーブルの上にあるコップを取って」と指示したとします。
ロボットがこの指示を実行するためには、言葉を理解するだけでは足りません。カメラからテーブルやコップの位置を認識し、どのように腕を動かせばコップを取れるのかを判断して、実際に身体を動かす必要があります。
今回は、そんなロボットの頭脳ともいえる「VLA」について、初心者向けに分かりやすく紹介します。
VLAとは?
VLAとは、Vision(視覚)、Language(言語)、Action(行動)の3つを組み合わせたAIモデルです。
Visionでは、ロボットに搭載されたカメラなどから周囲の状況を認識します。Languageでは、「コップを取って」「箱を棚に置いて」といった人間からの指示を理解します。
そしてActionでは、認識した状況と言葉による指示をもとに、ロボットがどのように動けばよいのかを決めます。
簡単に整理すると、下記のような関係です。
Vision:周囲を見る
Language:人間の指示を理解する
Action:実際に動く
この3つをひとつにつなげることで、人間が自然な言葉でロボットに仕事をお願いできるようになります。
VLMとの違いは?
VLAを理解するうえで知っておきたいのが「VLM」です。
VLMとは「Vision-Language Model」の略で、画像などの視覚情報と言葉を組み合わせて扱うAIモデルです。
例えば、AIに部屋の写真を見せて「机の上には何がありますか?」と質問すると、「コップと本があります」と答えるような使い方ができます。
つまり、VLMは「見る」と「言葉を理解する」を組み合わせたAIです。
一方、VLAにはさらに「Action」が加わります。
部屋を見て「机の上にコップがある」と理解するだけではなく、その情報をもとにロボットの行動へつなげます。
例えば、「机の上にあるコップを取って」という指示に対して、コップを認識したあと、実際にロボットアームを動かしてコップをつかむところまで行います。
つまり、VLMが「見て理解するAI」だとすれば、VLAは「見て理解して動くAI」と考えると分かりやすいでしょう。
VLAはどのように動く?
では、VLAを搭載したロボットは、どのように人間の指示を実行するのでしょうか。
例えば、テーブルの上にリンゴとコップがあり、人間がロボットに「リンゴを取って」と指示したとします。
まずロボットは、カメラを使って周囲の状況を確認します。そして、テーブルの位置やリンゴ、コップなどを認識します。
次に、「リンゴを取って」という人間の言葉を理解し、目の前にある物の中からリンゴを対象として判断します。
最後に、リンゴの位置まで腕を動かし、手を開いてリンゴをつかむという行動につなげます。
つまり、見る → 言葉を理解する → 何をするか判断する → 動くという流れです。
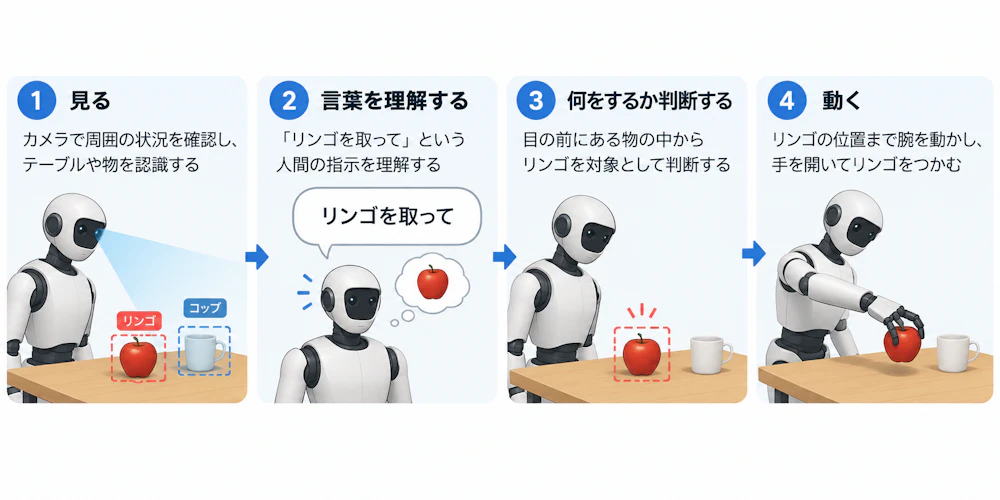
人間にとっては非常に簡単な行動ですが、ロボットが実行するためには、視覚、言語、判断、身体の制御をうまく組み合わせる必要があります。
VLAは、こうした複数の処理をつなげるための重要な技術です。
なぜVLAが注目されている?
VLAが注目されている理由のひとつが、ロボットをより汎用的にできる可能性があることです。
従来の産業用ロボットは、決められた場所で決められた作業を繰り返すことを得意としていました。
例えば、工場で同じ部品を同じ場所から取り、同じ場所へ移動させるような仕事です。
しかし、現実世界では状況が常に同じとは限りません。
物の位置が変わったり、初めて見る物が置かれていたり、人間から違う指示を受けたりすることがあります。
そのたびに人間が細かくプログラムを書き直していては、ロボットができる仕事は限られてしまいます。
VLAによってロボットが周囲の状況と言葉による指示を組み合わせて判断できるようになれば、ひとつのロボットがさまざまな作業に対応できる可能性があります。
これは、ヒューマノイドロボットを工場だけではなく、物流、店舗、オフィス、家庭など幅広い場所で利用するためにも重要な技術です。
ロボットFoundation Modelとは?
VLAとともに注目されているのが「ロボットFoundation Model」です。
Foundation Modelとは、大量のデータを使って学習し、さまざまな用途に利用できる基盤となるAIモデルのことです。
ChatGPTなどに使われているLLMも、Foundation Modelの代表的な例です。
ロボットの世界でも同じように、大量の画像、言葉、ロボットの動作データなどを学習させ、さまざまなロボットや作業に応用できるAIを作ろうという研究が進んでいます。
これまでのロボットでは、「この作業をするためのプログラム」「別の作業をするためのプログラム」のように、作業ごとに個別の仕組みを作ることが一般的でした。
一方、ロボットFoundation Modelでは、ひとつの大きなAIモデルをベースにして、さまざまな作業に対応することを目指します。
これが実現すれば、ロボット開発の考え方そのものが大きく変わる可能性があります。
VLAは汎用ロボット実現の鍵になる?
現在のロボットが得意なのは、特定の仕事を繰り返すことです。
しかし、人間は違います。
料理をしたあとに部屋を片付けたり、荷物を運んだあとにドアを開けたりと、状況に合わせてさまざまな仕事を行うことができます。
将来的にヒューマノイドロボットを家庭や職場で活用するためには、ロボットにも同じような柔軟性が求められます。
そこで重要になるのがVLAです。
ロボットが周囲を見て、人間の言葉を理解し、その場に適した行動を選択できるようになれば、ひとつのロボットにさまざまな仕事を任せられる可能性があります。
例えば、「テーブルを片付けて」「荷物を玄関まで運んで」「床に落ちている物を拾って」といった異なる指示に、同じロボットが対応する未来です。
こうした汎用的なロボットを実現するための「頭脳」として、VLAは重要な技術のひとつになっています。
VLAの現在の課題
VLAによってロボットは大きく進化していますが、人間と同じように何でもできる段階にはまだ達していません。
特に難しいのが、現実世界には予想外の状況が非常に多いことです。
例えば、ロボットがコップを取ろうとしても、コップが透明で認識しにくかったり、別の物が手前に置かれていたり、途中で人間がコップを移動させたりすることがあります。
さらに、AIが何をすべきか正しく判断できても、実際の身体を正確に動かせるとは限りません。
物を強く握りすぎれば壊してしまう可能性がありますし、弱すぎれば落としてしまいます。
そのため、VLAの性能だけではなく、カメラやセンサー、ロボットアーム、手の制御、安全性など、さまざまな技術を組み合わせる必要があります。
また、ロボットを賢くするためには大量の学習データも必要です。
インターネット上に大量の文章や画像が存在する生成AIとは違い、ロボットが現実世界で動いたデータを大量に集めるには時間やコストがかかります。
この「データをどう集めるのか」も、現在のロボットAIにおける重要な課題です。
LLMからVLAへ
生成AIの進化を大きな流れで見ると、AIが扱える世界が少しずつ広がっていることが分かります。
LLMは、大量の文章を学習することで、人間の言葉を理解して文章を生成できるようになりました。
そこから画像なども扱えるVLMが登場し、AIは「言葉」だけではなく「見る」能力も持つようになりました。
そしてVLAでは、そこに「行動」が加わります。
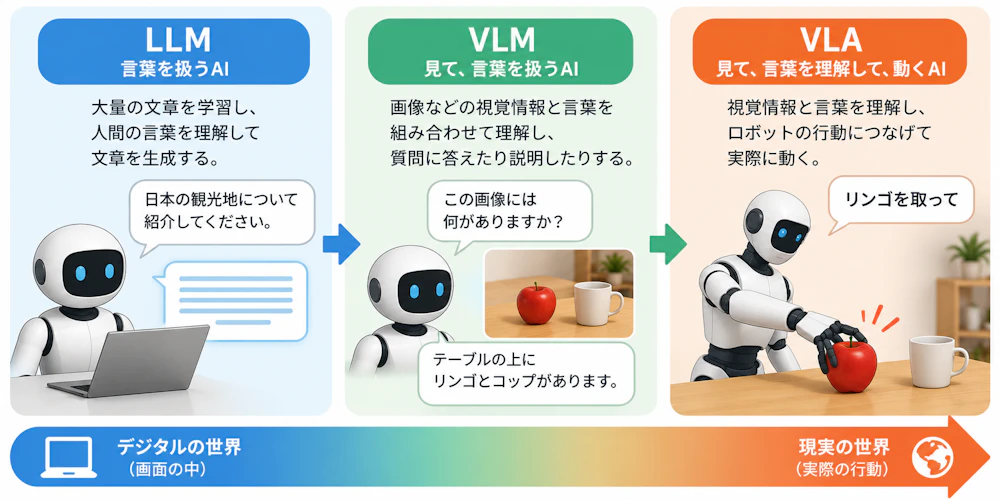
LLM:言葉を扱う
VLM:見て、言葉を扱う
VLA:見て、言葉を理解して、動く
という流れで考えると分かりやすいでしょう。
生成AIがパソコンやスマートフォンの画面の中だけで動く存在だとすれば、VLAはAIを現実世界へ連れ出すための技術のひとつともいえます。
まとめ
VLAとは、Vision(視覚)、Language(言語)、Action(行動)を組み合わせ、ロボットが周囲を見て、人間の言葉を理解し、実際の行動につなげるためのAIモデルです。
VLAの進化によって、ロボットは決められた動きを繰り返すだけではなく、その場の状況や人間からの指示に合わせて行動できるようになってきています。
将来的に、ひとつのロボットが工場、物流、店舗、家庭などでさまざまな仕事をこなすためにも、VLAは重要な技術になると考えられています。
しかし、ロボットが現実世界で安全に活動するためには、言葉や画像を理解するだけでは十分ではありません。
「この動きをすると、そのあと何が起こるのか」を予測する能力も重要になります。
そこで次に登場するのが「World Model」です。
次回は、AIが現実世界の仕組みを理解し、行動した結果を予測するための技術「World Model」について紹介します。
※ 本記事の内容は、執筆時点での情報に基づいています。最新の情報と異なる場合がございますので、あらかじめご了承ください。 また、記載されている内容は一般的な情報提供を目的としており、特定の状況に対する専門的なアドバイスではありません。 ご利用にあたっては、必要に応じて専門家にご相談ください。